模型变笨了吗
TL;DR
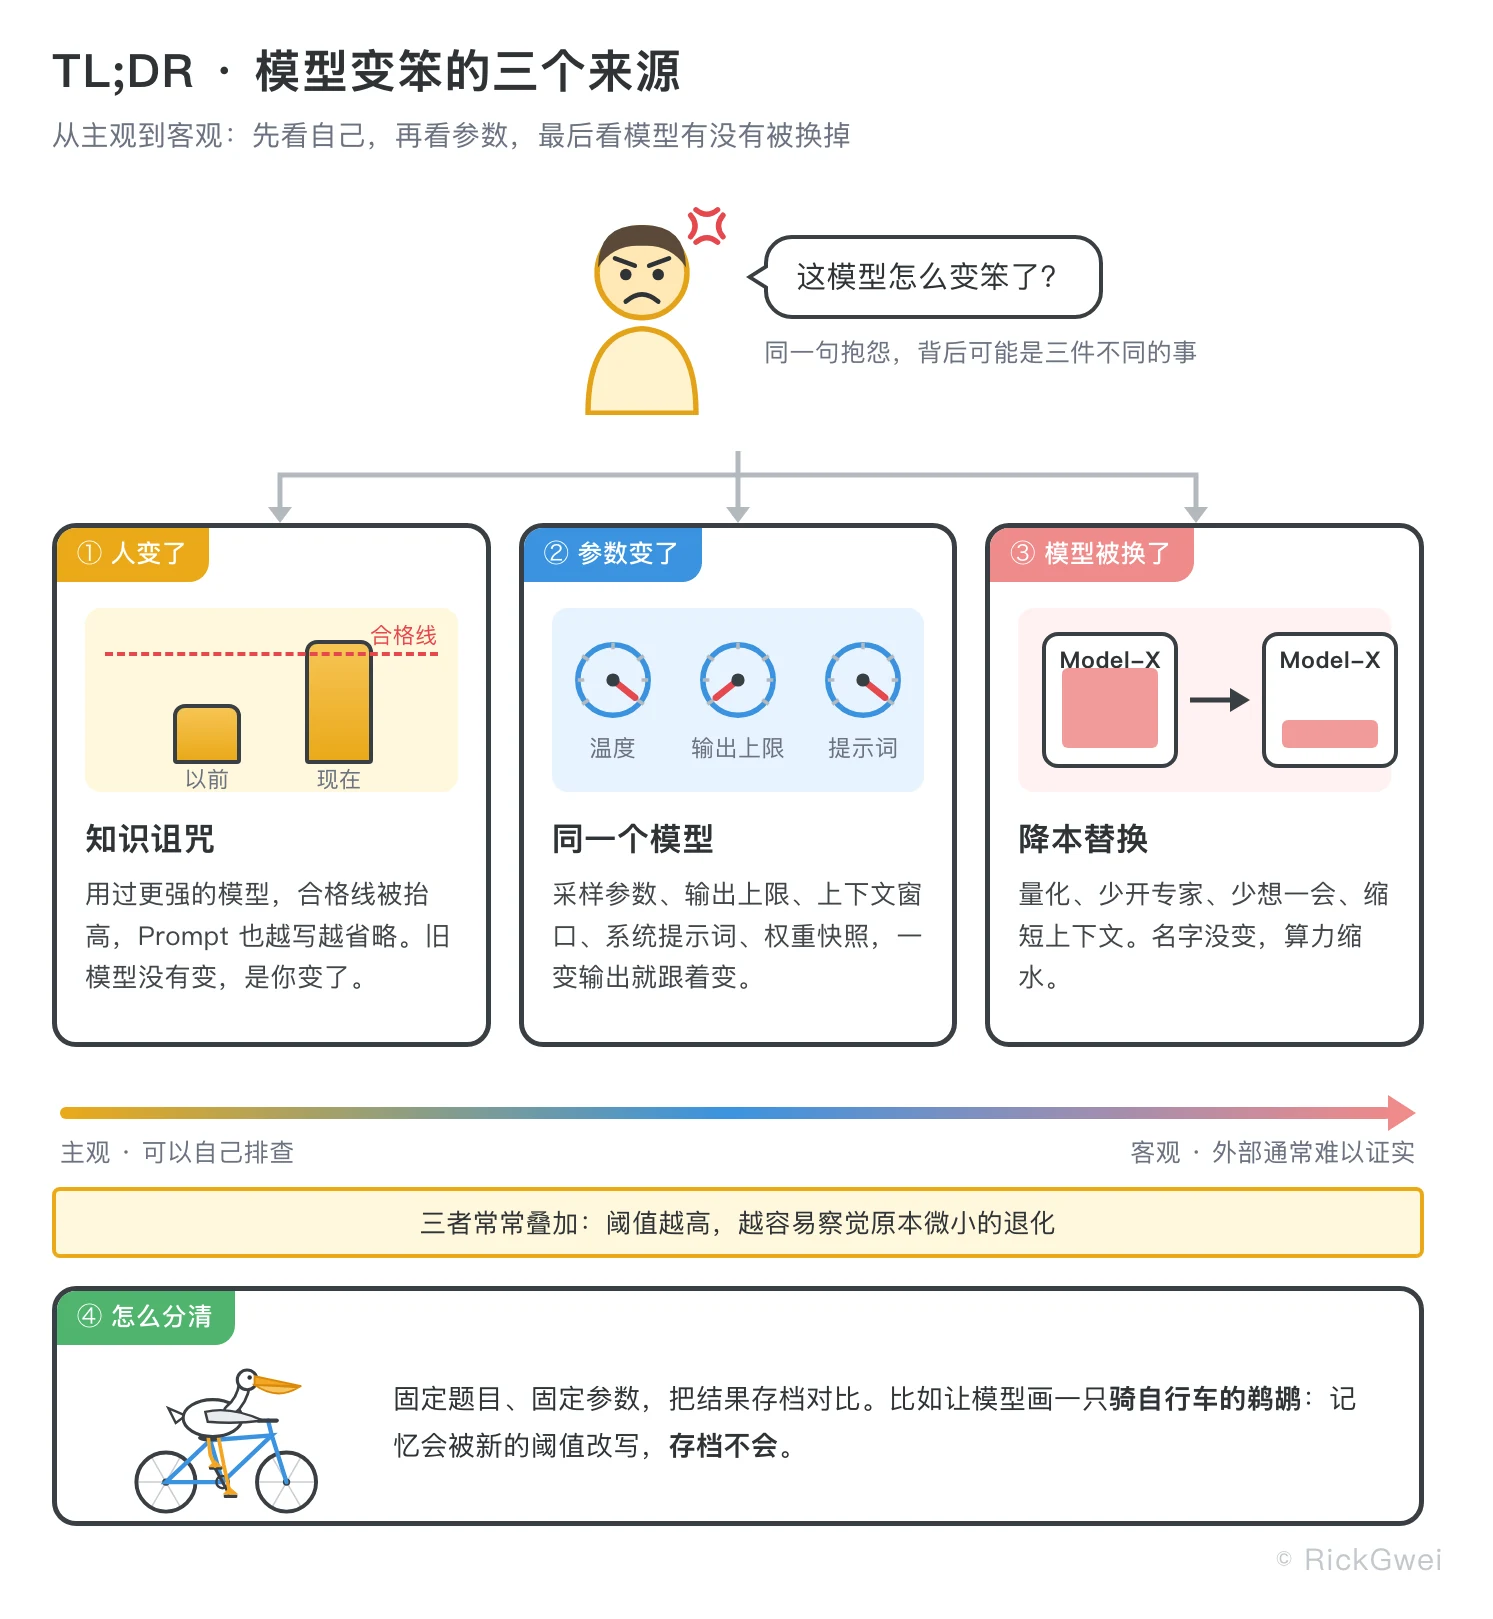
「模型变笨了」这个感受,通常有三个来源,从主观到客观依次是:
- 人变了:用过更聪明的模型之后,智力阈值被抬高,Prompt 也越写越省略。旧模型没有变,却再也难以忍受,这是知识诅咒。
- 参数变了:同一个模型,采样参数、输出上限、上下文窗口、系统提示词或权重快照一变,输出的风格和质量都会偏移。
- 模型被换了:为了降低推理成本,服务端可能换成量化版本、减少 MoE 激活的专家、压缩思考时间和上下文长度。名字没变,算力缩水了。
三者常常叠加。阈值被抬高以后,原本察觉不到的小幅退化也会变得明显。
要分清是哪一种,需要用固定的题目和参数反复测试,并把结果存档对比,比如让模型画一只骑自行车的鹈鹕。记忆会被新的阈值改写,存档不会。前两类可以靠自己排查;第三类在外部通常无法证实,只能作为解释框架。
一、人为因素:被抬高的智力阈值
知识诅咒是什么
知识诅咒(curse of knowledge)指的是:一旦知道了某件事,就很难再想象不知道它时的状态。这个概念由经济学家 Camerer、Loewenstein 和 Weber 在 1989 年提出,最初用来解释信息更多的一方为什么很难准确预判信息更少的一方会怎么做。
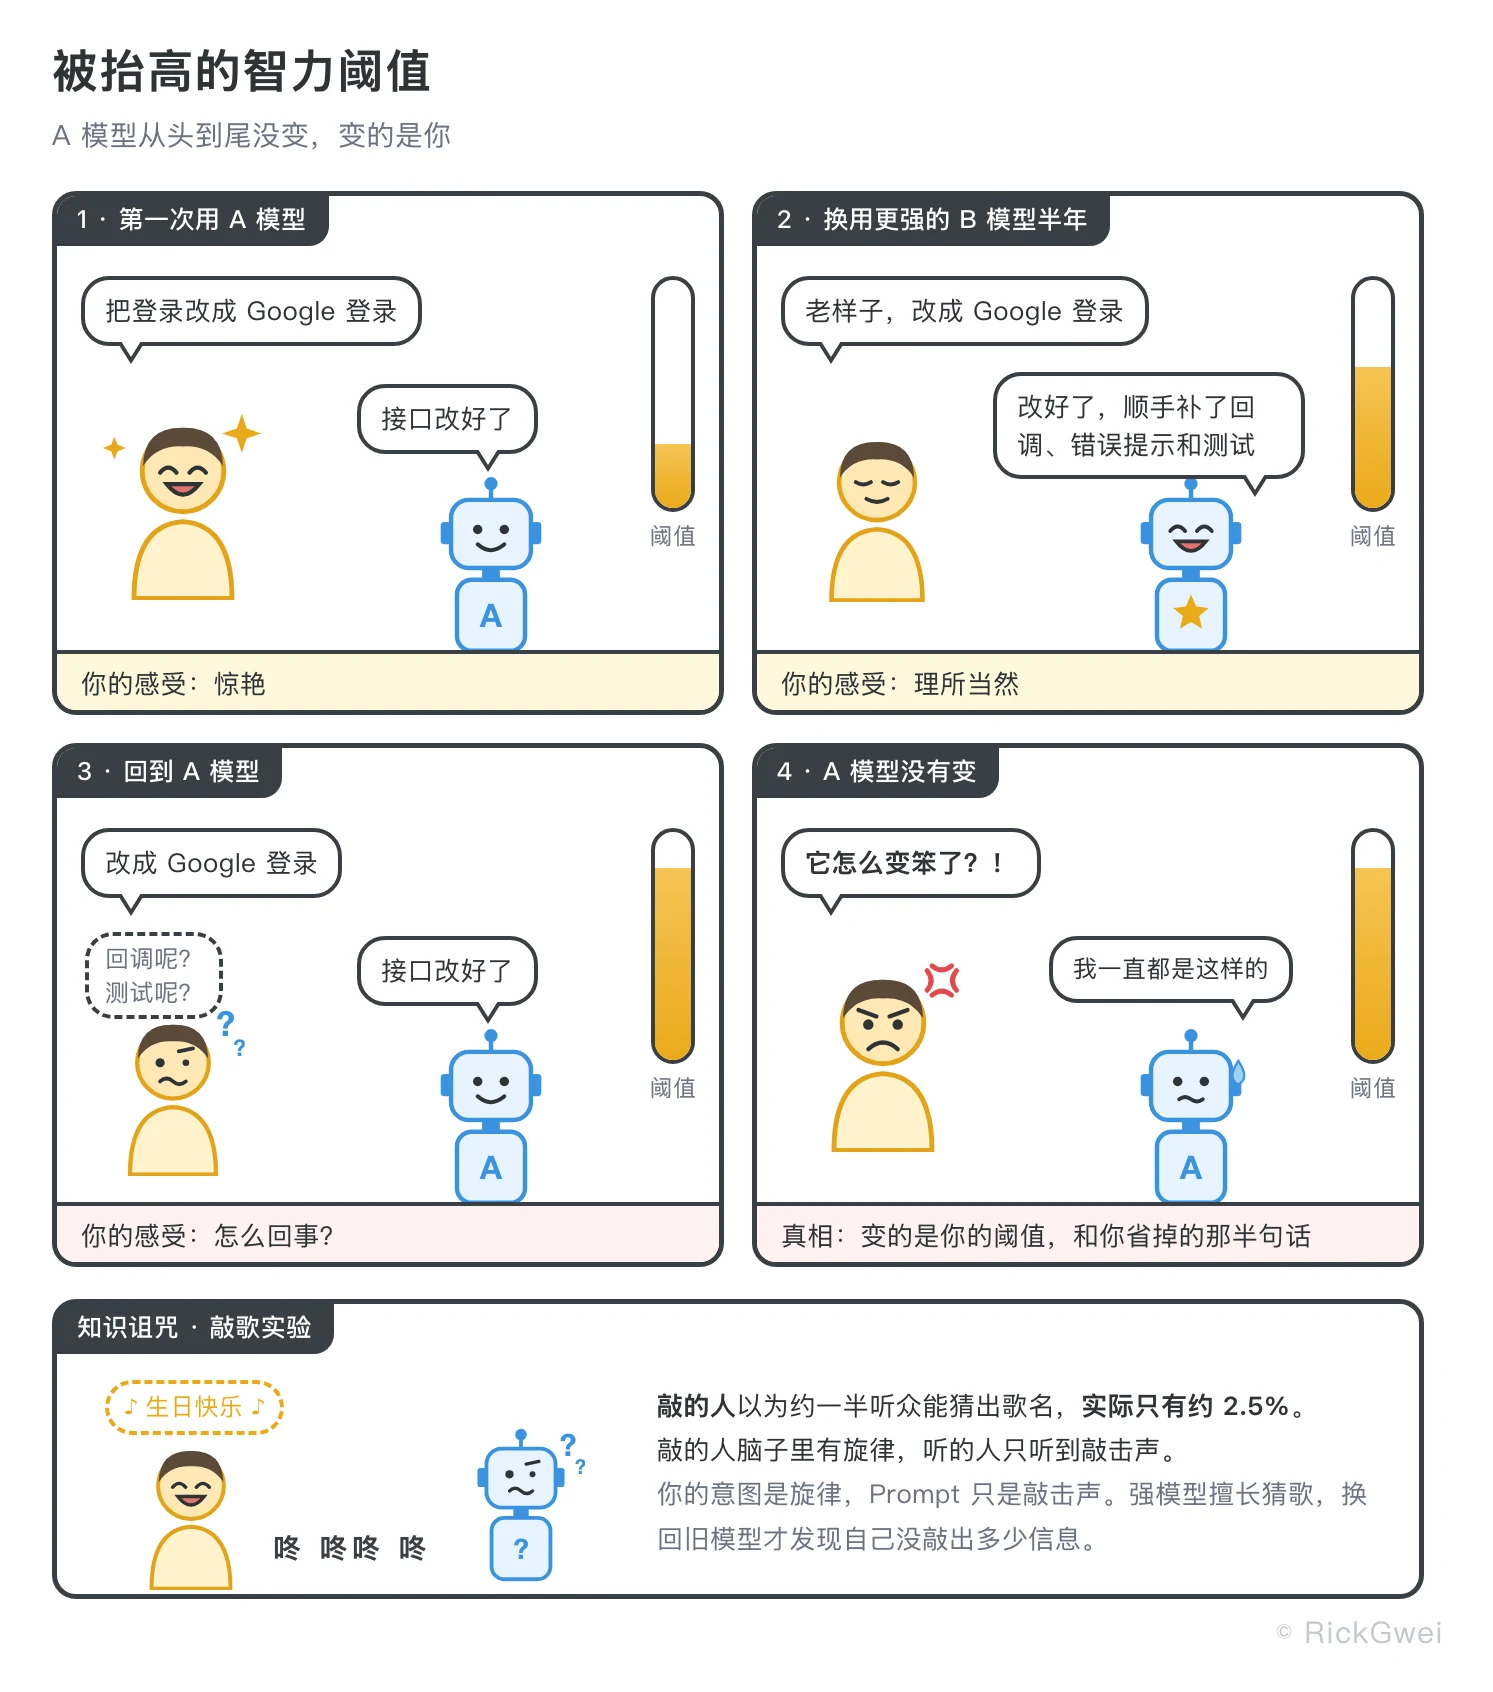
最常被引用的例子,是 Elizabeth Newton 1990 年在斯坦福做的「敲歌」实验。一组人在桌上敲出一首耳熟能详的歌的节奏,另一组人听敲击声猜歌名。敲的人预估大约一半的听者能猜出来,实际上 120 首里只猜中了 3 首,约 2.5%。敲的人脑子里一直响着旋律,很难意识到听的人只听到一串没有音高的敲击声。
和模型对话也是一样:你的意图是旋律,Prompt 只是敲击声。强模型像一个特别会猜歌的听者,凭几下敲击就能补出整段旋律。换回旧模型后,你才发现自己其实没敲出多少信息。
例子:智力阈值提高以后
生活里有个很常见的类比。和一个一点就通的同事合作半年,你交代事情时会越说越少;再换回一个需要把话说全的同事,就会觉得对方「怎么连这都不懂」。对方并没有变,变的是你的表达习惯和期待。
放到模型上,就是插图里的四格:
- 第一次用 A 模型,你只说了一句「把登录改成 Google 登录」,它改对了接口,你觉得很惊艳。
- 之后半年你换用更强的 B 模型。同样一句话,它顺手补了回调处理、错误提示和测试,你开始默认这些都属于「改好」的一部分。
- 某天回到 A 模型,你给出同样简短的指令,它只改了接口,回调和测试都没有。
- 你觉得 A 变笨了。可 A 的输出和半年前一样,变的是你的阈值,以及你省掉的那半句话。
这里说的智力阈值,是你心里「这个回答算合格」的那条线。它会随着见过的最好结果往上走,却很少往回落。
哪些行为让用户觉得模型「好用」
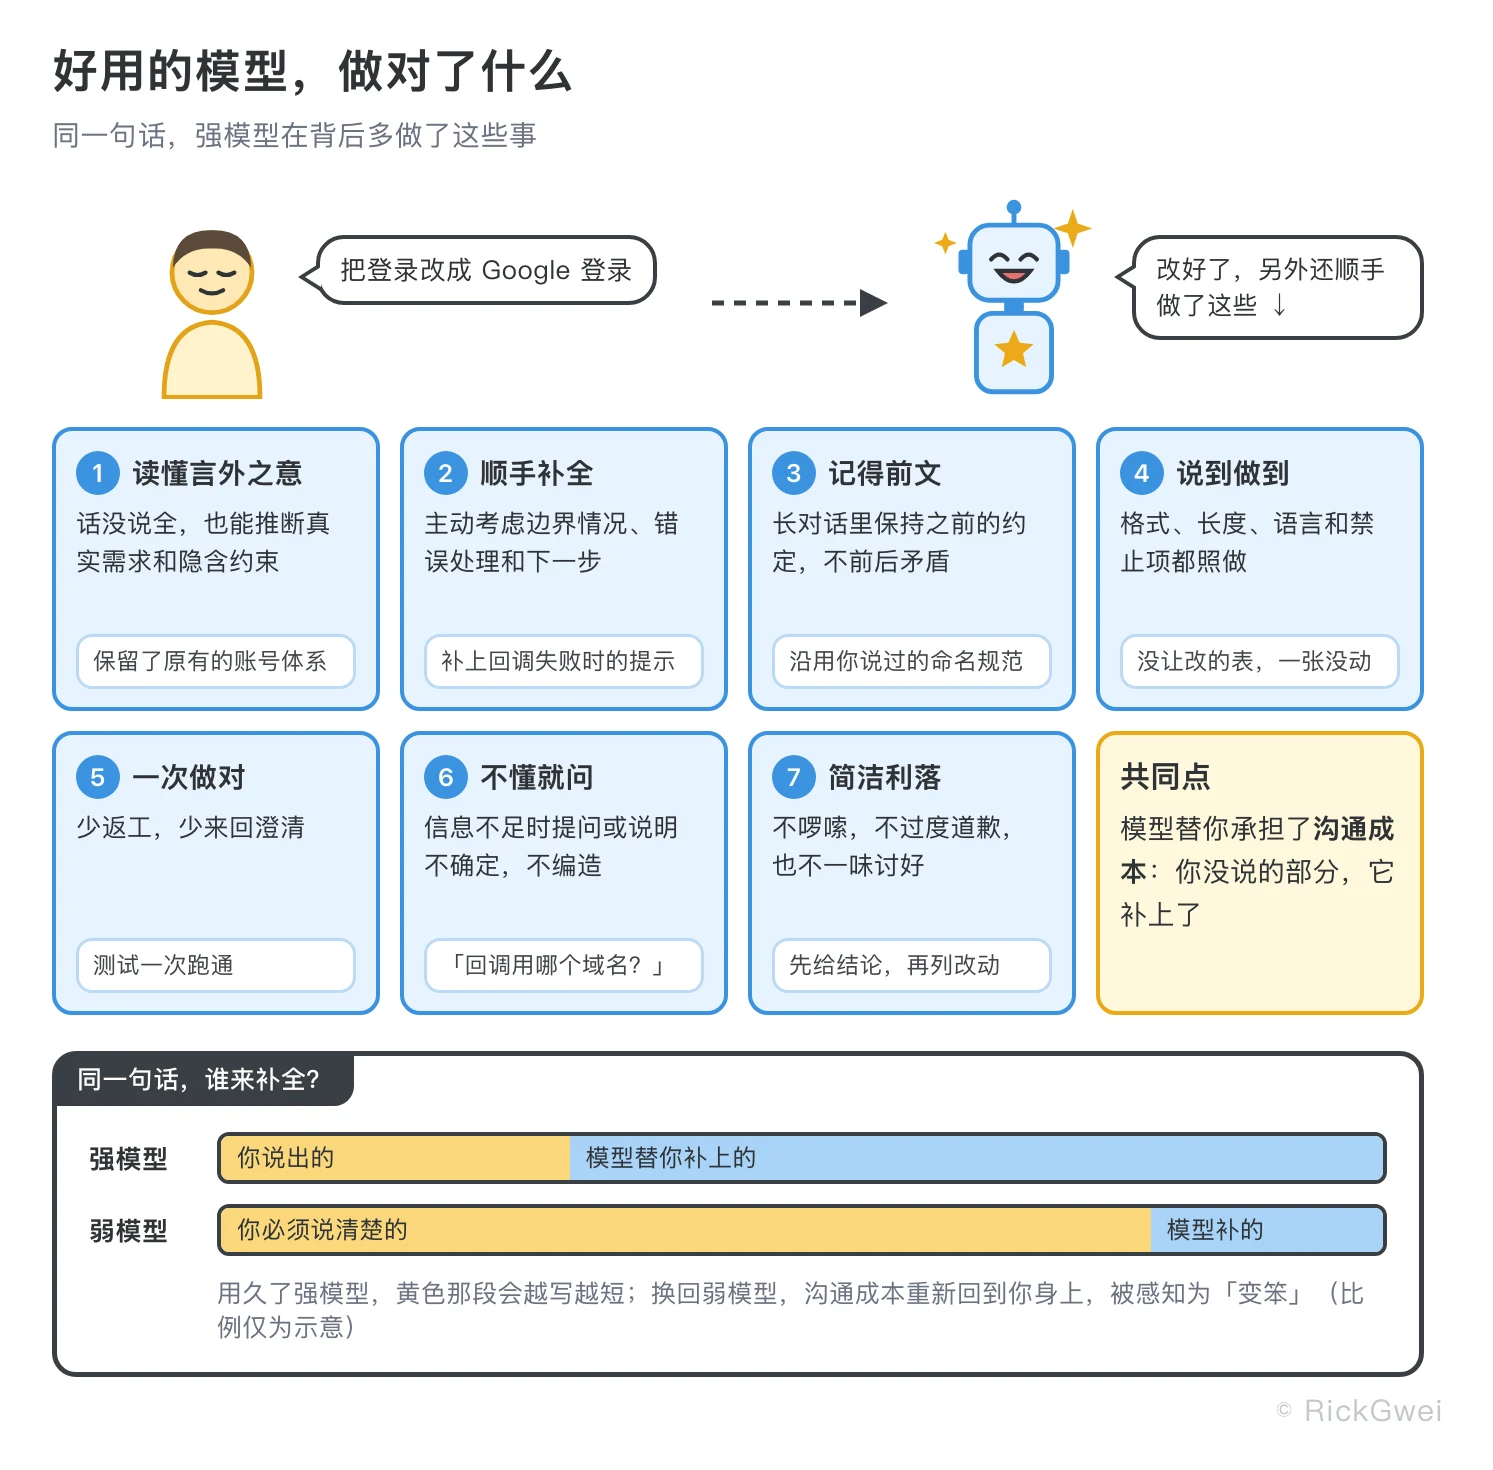
回头看 B 模型让人觉得好用的地方,大致是这几种行为:
- 读懂言外之意:话没说全,也能推断出真实需求和隐含约束。
- 顺手补全:主动考虑边界情况、错误处理和下一步,不只完成字面要求。
- 记得前文:长对话里保持之前的约定,不前后矛盾。
- 说到做到:格式、长度、语言和禁止项都照做。
- 一次做对:少返工,少来回澄清。
- 不懂就问:信息不足时会提问,或者说明自己不确定,而不是编造。
- 简洁利落:不啰嗦,不过度道歉,也不一味讨好。
这些行为有一个共同点:模型替你承担了沟通成本。强模型把「你没说的部分」补上了,用久了,这部分成本就从你的意识里消失。换回弱模型,成本重新回到你身上,就被感知为「变笨」。
几种放大效应
还有几种常见的心理倾向,会让这种感受更强烈:
- 参照点依赖与损失厌恶:从强模型退回弱模型,会被感知为一种损失,而损失比同等的收益更显眼。
- 享乐适应:新模型带来的惊喜会慢慢消退,惊喜的消失本身也容易被误读成「变差了」。
- 负面偏差与确认偏差:失败案例更容易被记住和转发;一旦怀疑模型变笨,就会格外留意它的失败。
- 采样随机性:同一个 Prompt 的结果本身就有波动,几次偶然的失败就足以形成印象。
二、参数改变:同一个模型,不同的输出
先理解模型怎么「挑词」
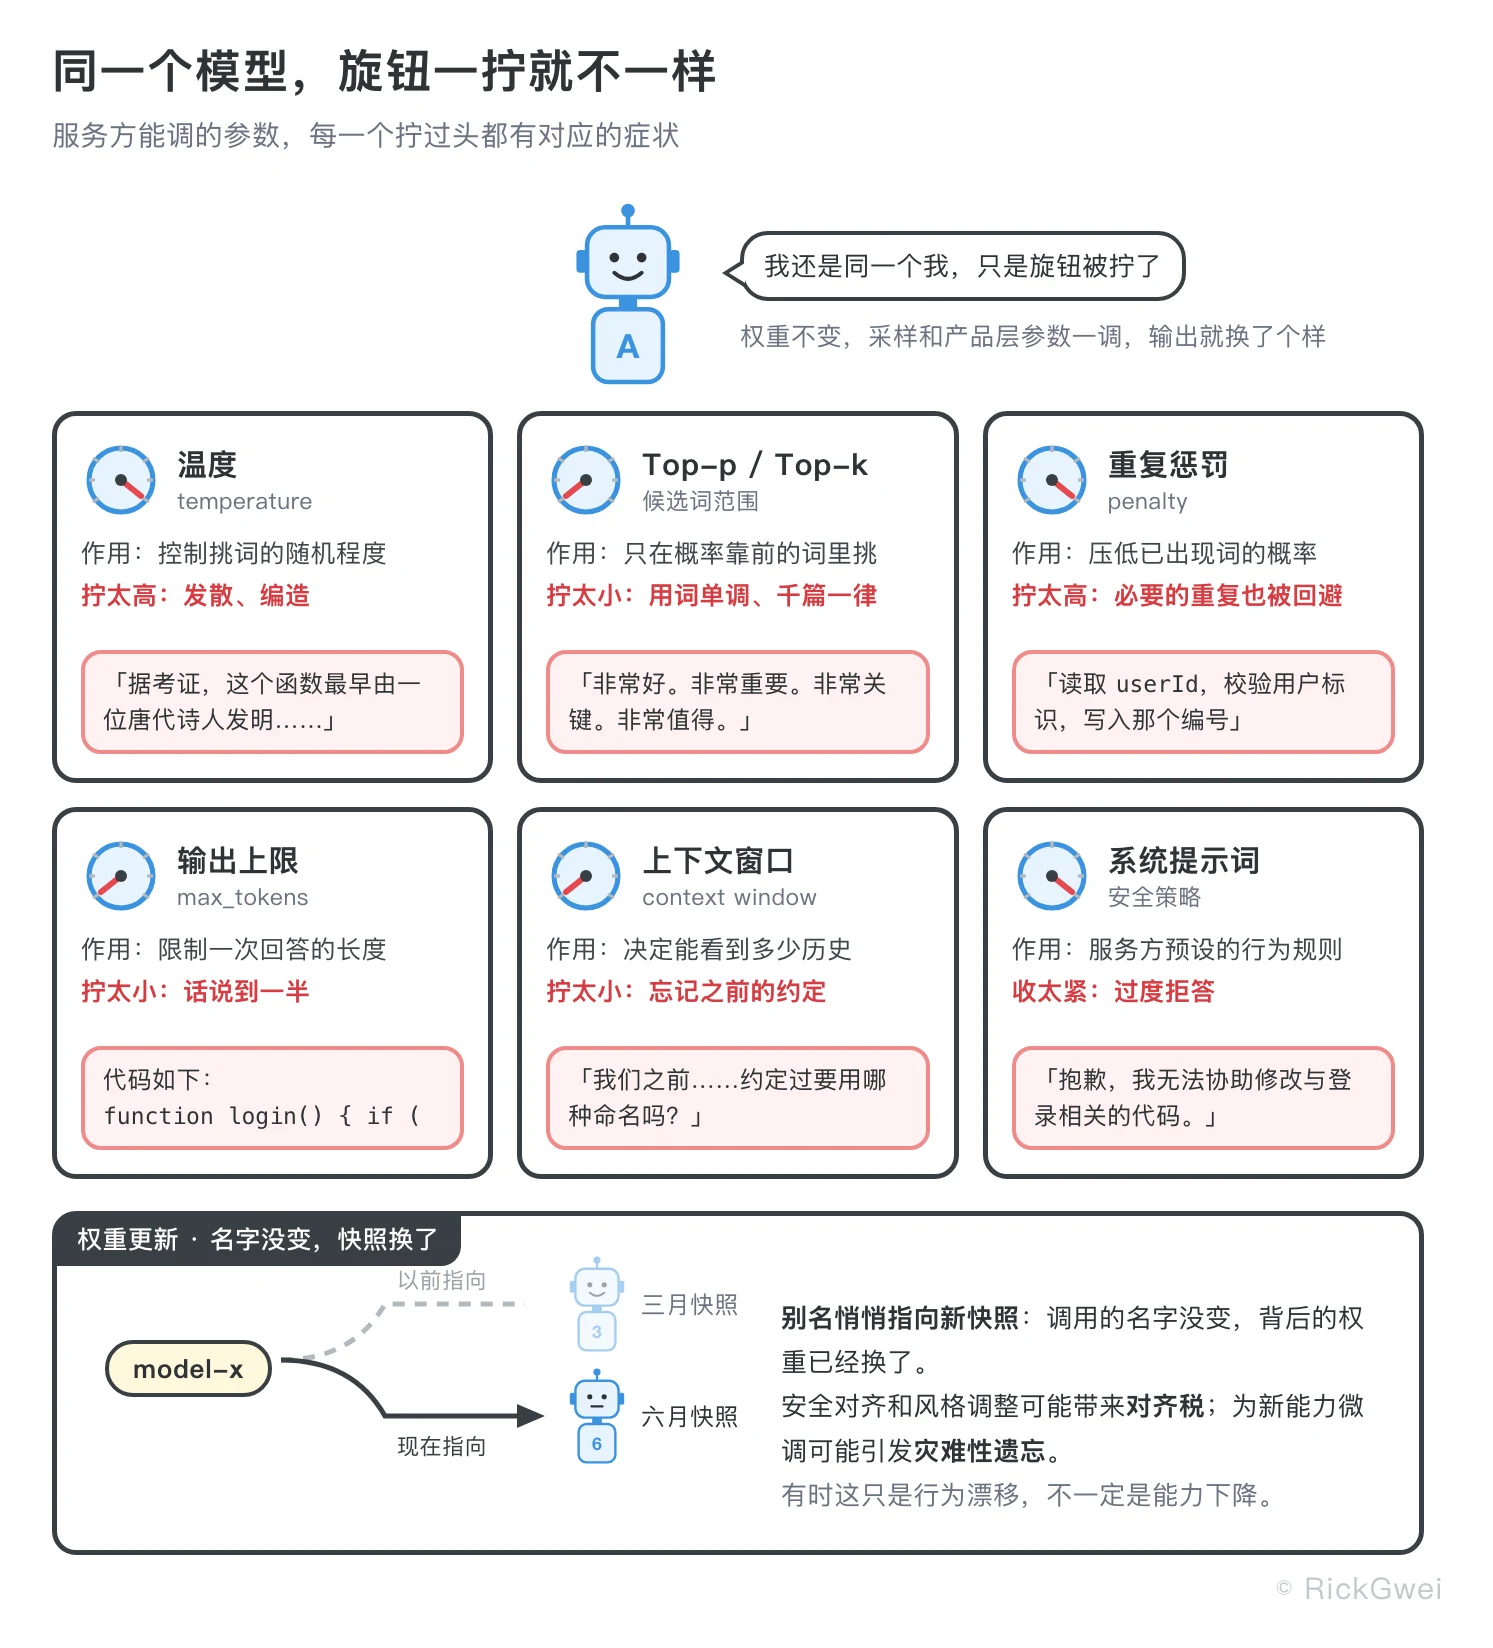
模型每一步输出的,是下一个 token 的概率分布,最后说出哪个词,由采样参数决定。所以同一组权重,换一组参数,输出的风格、稳定性和长度都会不同。
采样参数
- temperature(温度):控制概率分布的平滑程度。调高后输出更多样,也更容易跑偏和编造;调低后更稳定,但会变得死板,甚至复读。
- top-p(核采样):只在累计概率达到 p 的候选词里挑。p 太小会让用词单调,太大会混入低概率的噪声。
- top-k:只在概率最高的 k 个候选词里挑。作用与 top-p 类似,只是一刀切的截断。
- 重复惩罚(frequency / presence penalty):压低已经出现过的词的概率,避免车轱辘话。惩罚太高,模型会刻意回避必要的重复,比如代码里的变量名和专业术语。
不同任务的最优值并不相同:代码和数学适合低温,创意写作可以高一些。服务方一旦统一调整默认值,必然会让一部分任务变差。
长度与上下文参数
- 输出上限(max_tokens):调低后回答变短,代码写到一半被截断,长文直接「此处省略」。
- 上下文窗口与截断策略:长对话里早期的信息被丢弃或压缩,模型就像忘了之前的约定。
产品层参数
- 系统提示词:服务方预设的行为说明。它一改,语气、格式偏好和回答长度都会跟着变。
- 安全策略:收紧之后会出现过度拒答,正常请求也被拦下。
权重更新:名字没变,快照换了
很多模型名其实是版本别名,比如 gpt-4o 或各家的 *-latest,背后指向的快照会随更新替换。用户没有改任何设置,用的却已经是另一个模型。
新快照不一定全面更好。安全对齐、风格调整和 RLHF 更新,可能在某些能力上付出「对齐税」;为新能力做微调时,也可能出现灾难性遗忘,一个方向变好,另一个方向退步。
2023 年,Chen、Zaharia 和 Zou 发表了 How Is ChatGPT’s Behavior Changing over Time?,对比 GPT-4 的三月版和六月版,发现两者在判断质数、生成代码等任务上的表现差异很大。这篇论文一度被当作「GPT-4 变笨了」的证据。但 Narayanan 和 Kapoor 随后在 Is GPT-4 getting worse over time? 中指出,那份质数测试集里全是质数,模型可能只是从倾向回答「是」变成了倾向回答「否」。这更像是行为漂移,不一定是能力下降。
这个区分很重要:能力是模型能做到什么,行为是它默认会怎么做。参数和快照的变化往往先改变行为,用户感知到的却是能力。
体感和实际更新也并不总是对得上。2023 年底,大量用户抱怨 GPT-4「变懒」,ChatGPT 官方账号回应称,模型自 11 月 11 日以来就没有更新过,这种变化也不是有意为之。反过来,一次真正的更新又可能被用户迅速察觉:2025 年 4 月,OpenAI 回滚了一次 GPT-4o 更新,因为那次更新让模型变得过度讨好用户。
三、降本:名字没变,算力缩水
为什么会有降本的动机
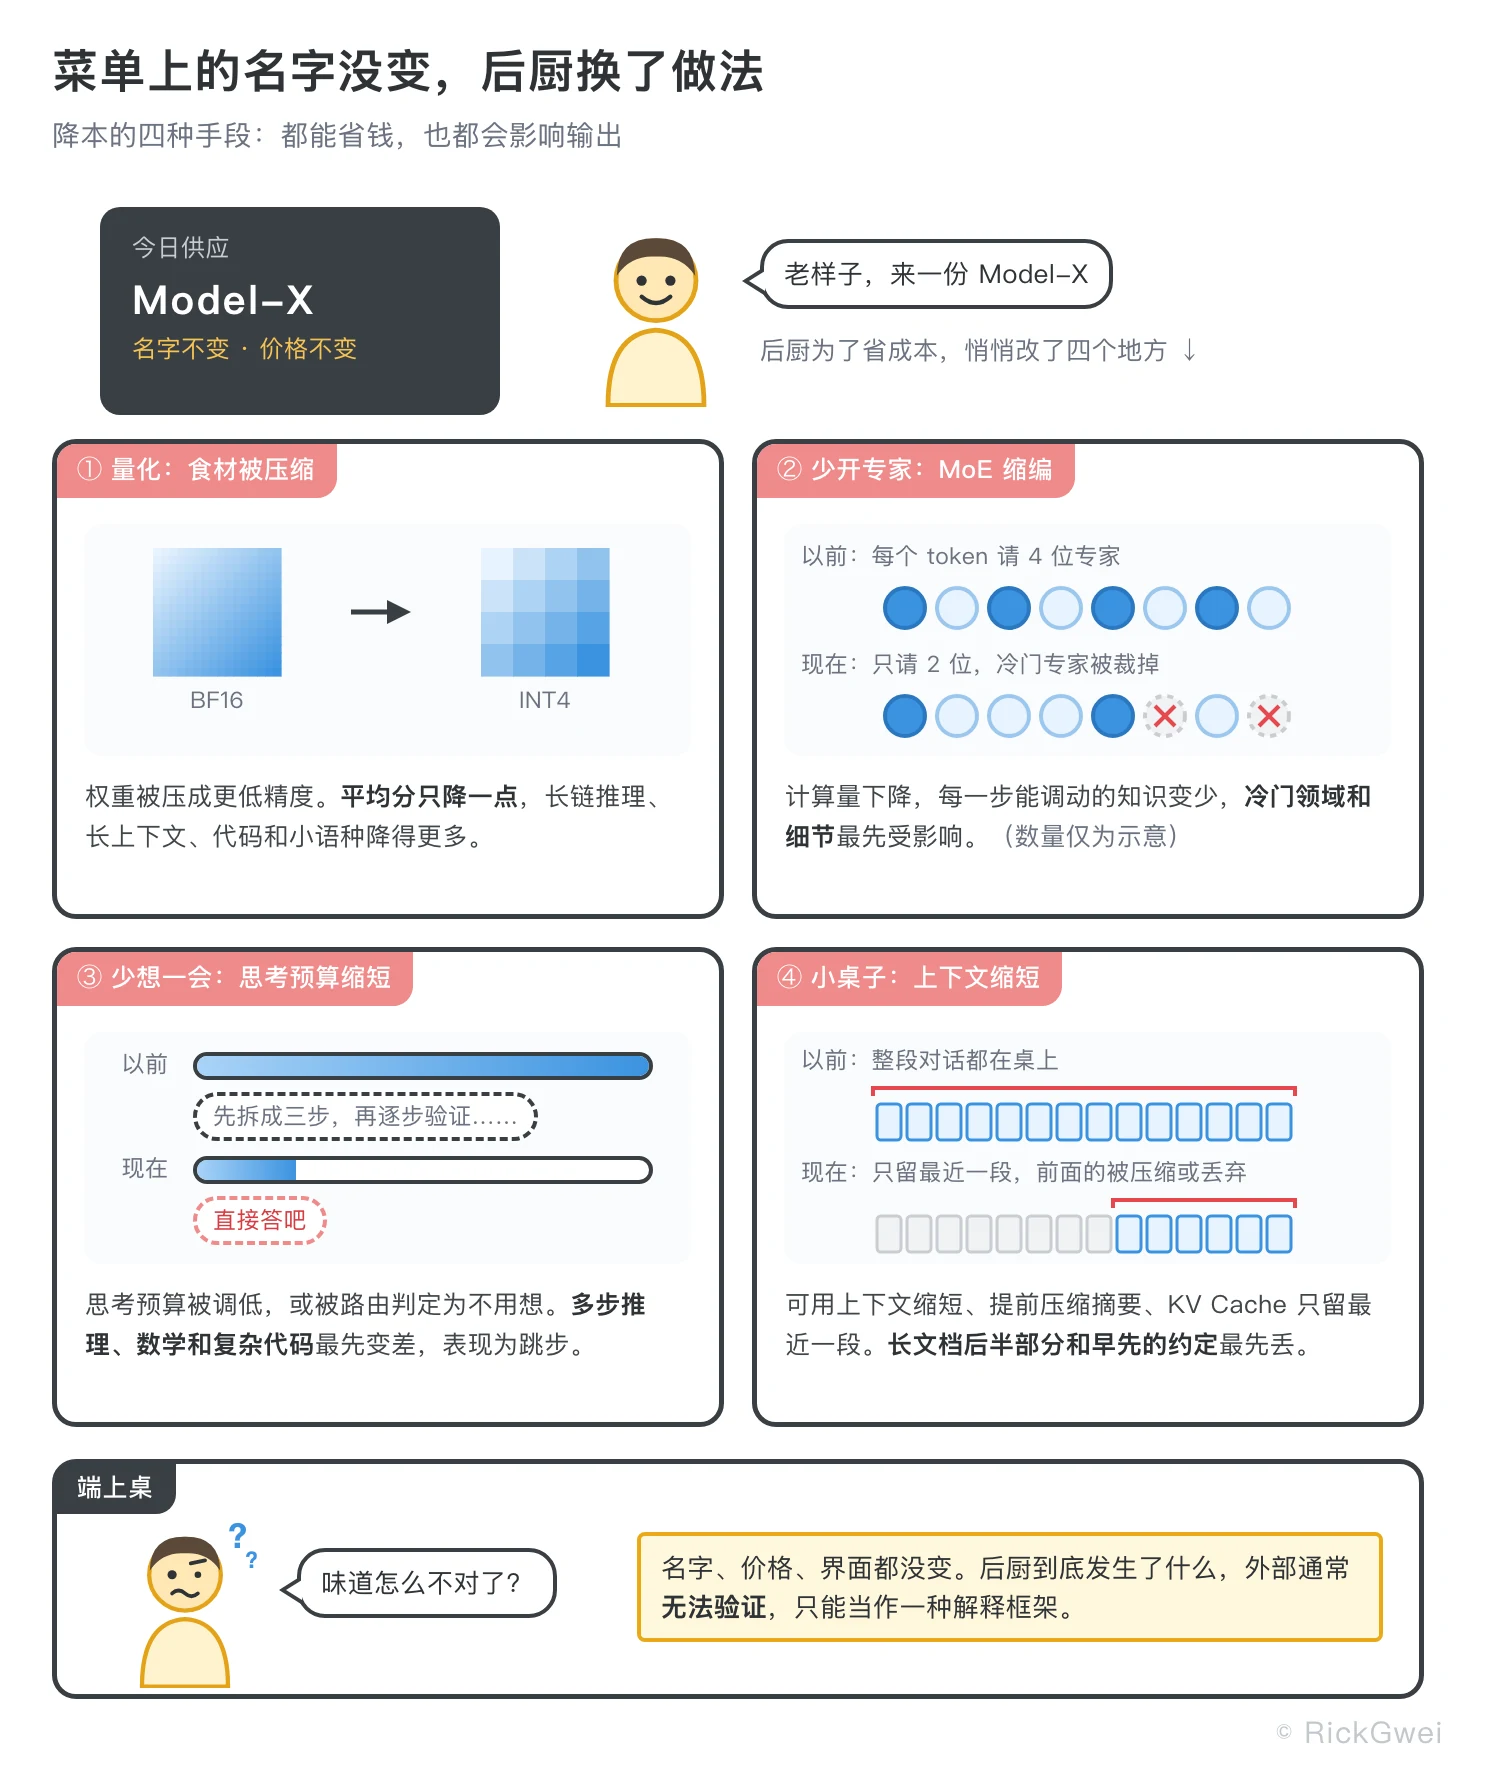
推理成本随 token 数和算力线性增长,用户越多,推理成本在总成本里的占比越高。在订阅制下,重度用户消耗的算力可能远超订阅费,服务方有很强的动机,在不改名字、不改价格的前提下降低单次推理的成本。
下面四种手段都能省钱,也都会直接影响输出质量。
手段一:量化,把权重压成更低的精度
量化是把权重(以及 KV Cache、激活值)从 BF16 / FP16 压到 FP8、INT8 甚至 INT4。显存占用成倍下降,吞吐提高,同样的硬件能服务更多请求。
代价是:平均指标通常掉得很少,损失却集中在长尾,比如长链推理、长上下文、精确计算、代码和低资源语言。
- LLM.int8()(Dettmers 等,2022)发现,大模型里存在少量数值很大的离群特征,它们对模型表现至关重要,粗暴量化会破坏它们。
- How Does Quantization Affect Multilingual LLMs?(Marchisio 等,2024)发现,自动指标低估了量化带来的退化,人工评估下降得更明显,非拉丁文字的语言受影响更大。
- Accuracy is Not All You Need(Dutta 等,2024)发现,即使量化前后准确率相近,仍有大量题目的对错发生了「翻转」。基准分数没变,用户遇到的具体回答已经变了。
最后一点和用户体感的关系最直接:你在意的从来不是平均分,而是自己手上那几道题。
开源模型的情况更复杂。同一个模型由不同推理服务商托管时,量化精度和推理实现各不相同。Moonshot 为此给 Kimi K2 发布了 K2 Vendor Verifier,用官方基准检查第三方服务商的工具调用是否准确。
手段二:减少 MoE 激活的专家
MoE(混合专家)模型内部有很多「专家」子网络,每个 token 由路由器挑出少数几个参与计算,所以总参数很大,单次计算量却不大。例如 DeepSeek-V3 总参数 671B,每个 token 只激活约 37B。
降本的做法,是在推理时减少每个 token 激活的专家数,或者裁剪、合并较少被用到的专家。这方面已经有不少研究,比如 Not All Experts are Equal(Lu 等,2024)就提出了专家裁剪和动态跳过的方法。
计算量下降了,每一步能调动的「知识」也变少了,冷门领域和细节最先受影响。
手段三:缩短思考时间
推理模型会先生成思考 token 再作答。思考越长,正确率通常越高,成本和延迟也越高。OpenAI 在发布 o1 时就展示过,正确率会随推理时的计算量增加而提升。
反过来,调低默认的思考预算或 reasoning effort,或者由路由判断「这道题不需要想」而直接作答,都能省下不少算力。简单题几乎不受影响,多步推理、数学和复杂代码的正确率会下降,表现为跳步、想得浅。
路由本身也会出问题。GPT-5 发布当天,负责在快速模型和思考模型之间切换的自动路由出了故障,Sam Altman 事后承认,这让 GPT-5「看起来笨了很多」。
手段四:缩短思考上下文
模型能看到的上下文越长,KV Cache 占用的显存越多,长上下文请求的成本也越高。
降本的做法包括:限制实际可用的上下文窗口、更早触发对话压缩和摘要、对 KV Cache 做量化,或者只保留最近的一段。代价是长文档后半部分丢信息,长对话里忘记约定,多轮工具调用中丢失中间结果。
Anthropic 2025 年 9 月发布的事故复盘提到,从 8 月 5 日起,部分 Sonnet 4 请求被错误路由到为 1M 上下文窗口配置的服务器上,导致回答质量下降。那是 bug 而不是降本,但它说明上下文配置的变化会被用户明显感知。
边界
这四种手段在工程上都真实存在,在开源推理服务中也被广泛使用。但某家闭源厂商是否在用、什么时候用,外部通常无法证实。Anthropic 在同一份复盘中就明确声明,他们不会因为需求、时段或服务器负载而降低模型质量。
所以这一段更适合当作解释框架:当你确认不是自己的阈值变了、也不是参数变了,它能帮你理解还剩下哪些可能。
四、怎么判断:画一只骑自行车的鹈鹕
鹈鹕测试是什么
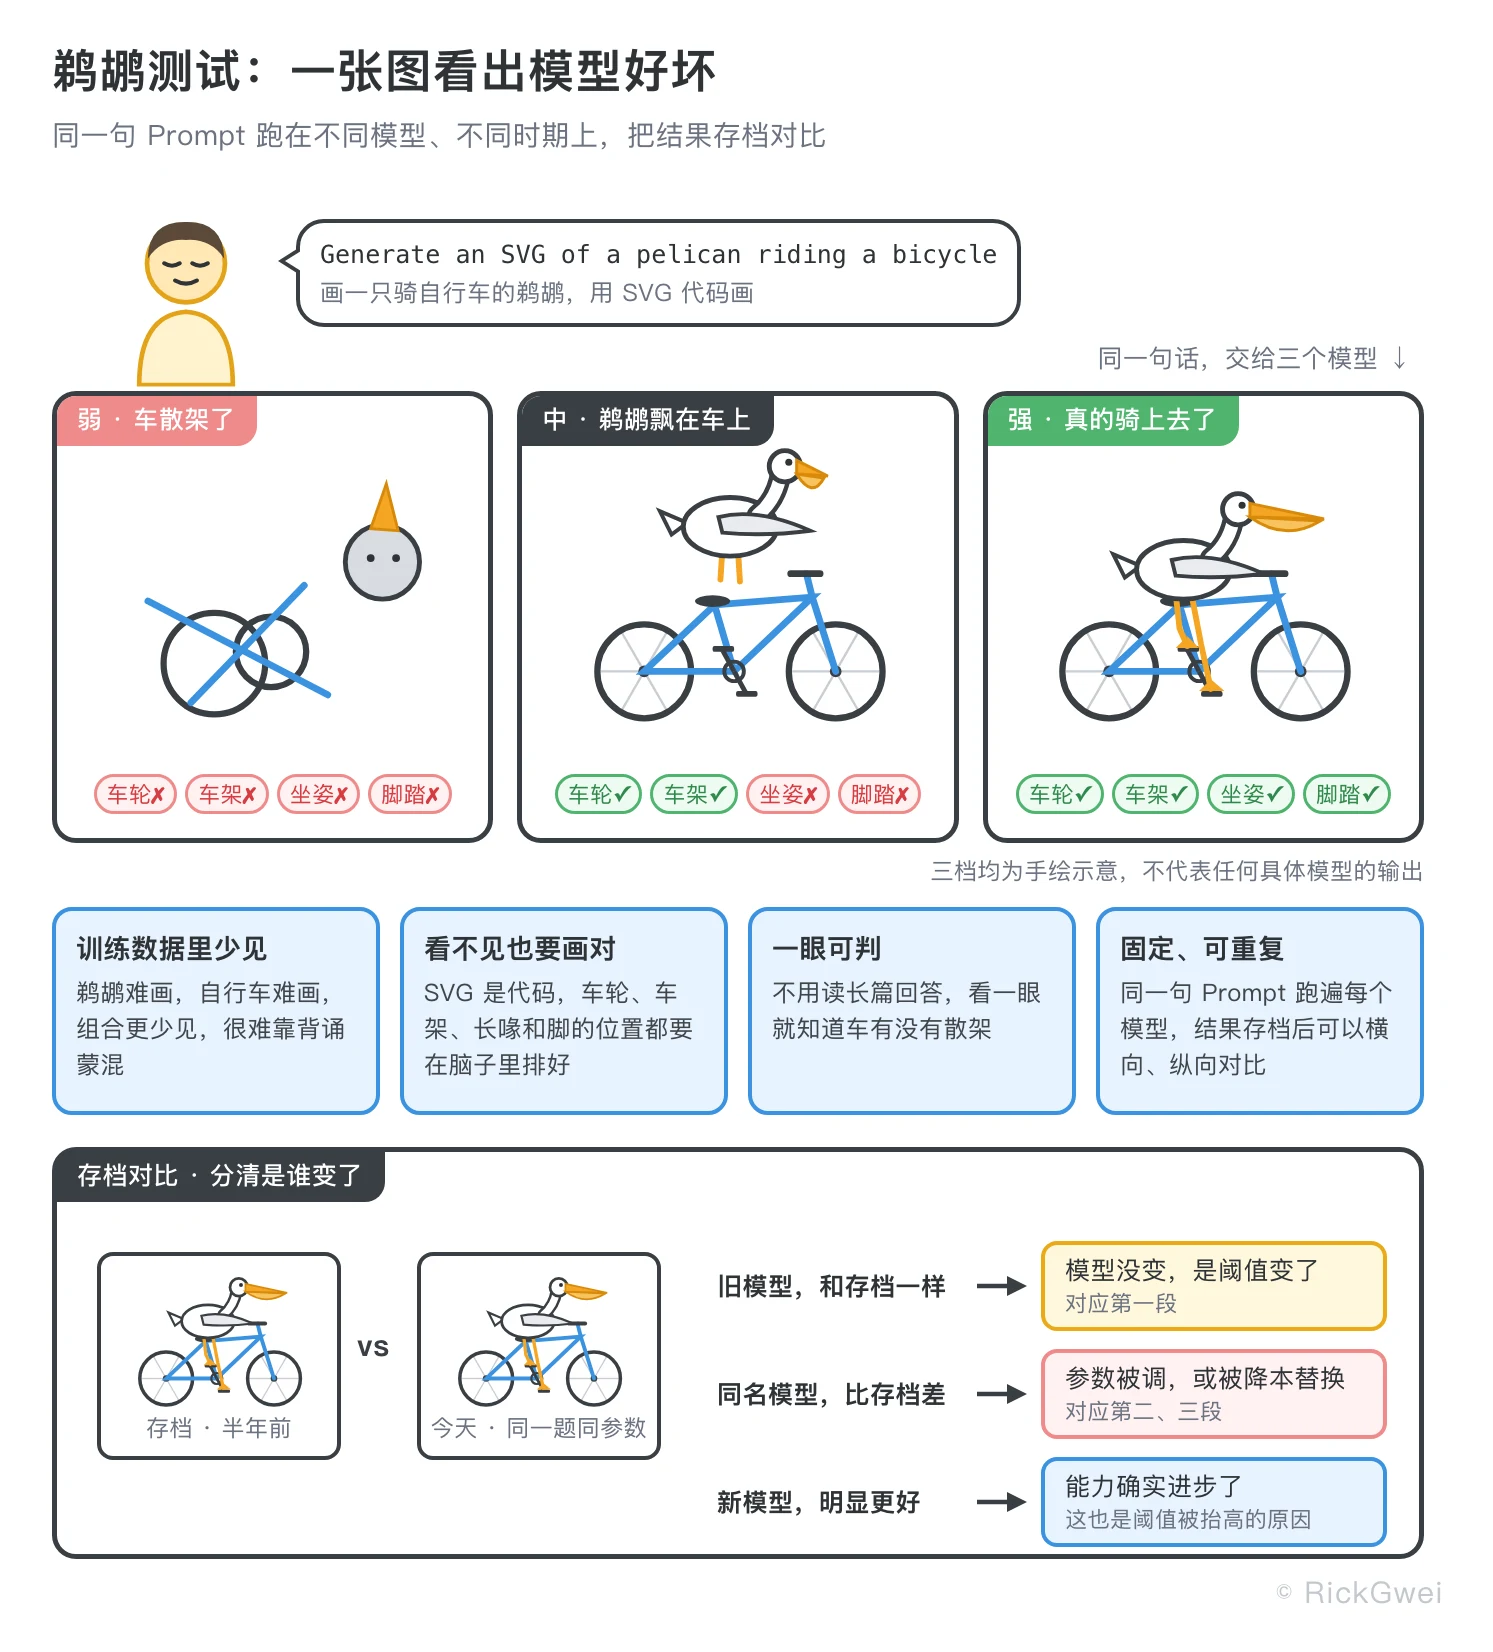
2024 年 10 月,Simon Willison 开始用同一句 Prompt 测试每一个新发布的模型:
Generate an SVG of a pelican riding a bicycle
也就是让模型用 SVG 代码,画一只骑自行车的鹈鹕。这个测试后来在社区里流传开来,新模型发布时,常有人第一时间贴出它画的鹈鹕。2025 年 6 月,他在 AI Engineer World’s Fair 上做了一场演讲,用鹈鹕串起了半年来的模型发布。
为什么一只鹈鹕能看出模型好坏
- 训练数据里几乎没有现成答案:鹈鹕难画,自行车也难画,两者的组合更少见,模型很难靠背诵蒙混过关。
- 看不见也要画对:SVG 是代码,模型要在「脑子里」安排好车轮、车架、鹈鹕的身体、长喙和踩在脚踏上的脚,考的是空间推理和代码能力。
- 结果一眼可判:不用读长篇回答,看一眼就知道车有没有散架、鹈鹕是不是坐在车上。
- 固定、便宜、可重复:同一句 Prompt 可以跑在每一个新模型上。结果保存下来,就能横向比较不同模型,也能纵向比较同一个模型的不同时期。
它为什么能对抗知识诅咒
人的记忆会被新的阈值悄悄改写,保存下来的图不会。半年前的鹈鹕和今天的鹈鹕并排放在一起,才谈得上判断。
对照前三段,判断逻辑大致是:
- 旧模型的鹈鹕和存档一样:模型没变,是你的阈值变了(第一段)。
- 同一个模型名,鹈鹕画得比存档差:参数被调整了,或者背后的模型被换了(第二、三段)。
- 新模型的鹈鹕明显更好:能力确实进步了,这也是你的阈值被抬高的原因。
鹈鹕测试的局限
- 只测一种能力:空间推理加 SVG 代码,不能代表写作、长上下文或工具调用。
- 单次结果有随机性:同一个模型多跑几次,鹈鹕的样子也会不同。
- 可能被针对性训练:题目出名以后,厂商可能专门优化它。Simon 在 What happens if AI labs train for pelicans riding bicycles? 里给过应对办法:如果某个模型突然画出一只特别好的鹈鹕,就换成别的动物骑别的交通工具再测;如果那些明显更差,发生了什么也就一目了然。
做一个你自己的「鹈鹕」
鹈鹕测的是一种公开、通用的能力。要判断模型在你手上是不是变笨了,最好有一套自己的「鹈鹕」:
- 私人评测集:从自己真实的工作里挑 10 到 20 个固定任务。题目不公开,也就不容易被针对性训练。
- 固定变量:指定模型快照版本,固定 temperature、思考预算和系统提示词。
- 多次采样:同一题跑多次,看结果的分布,而不是看单次运气。
- 盲测:隐藏模型名称再评价,和旧模型对比时尤其需要。
- 存档:记录日期和版本,对照厂商的更新日志和状态页。
- 区分 API 和产品端:网页和 App 里还叠加了系统提示词、路由和上下文管理,和直接调用 API 不是一回事。